添加计算节点
Node 通过主动连接 Manager 加入集群,并上报计算资源。最稳妥的入口是管理员控制台 → 基础设施 → 节点列表 → 注册节点,复制控制台生成的完整引导命令到目标机器执行。
前置条件
- 已在集群管理创建启用的 Docker 集群。当前后端尚不支持创建 Kubernetes 集群。
- 目标机器安装并能运行 Docker Engine,且能访问 Manager 的控制面地址与镜像仓库。
- 如果要运行 NVIDIA 或 Ascend 推理容器,先在目标机验证相应驱动与容器运行时。仅安装宿主机驱动不足以保证容器能看到设备。
- Manager 的
LLMPOD_NODE_MANAGER_IP已配置为节点机可访问的 IP、域名或反向代理 URL;留空时引导地址可能回落到localhost,只适合同机。 - 明确一个节点互联 IP:其他节点能用它访问这台机器。它与“节点连接 Manager 的地址”不是同一个设置。
使用控制台引导
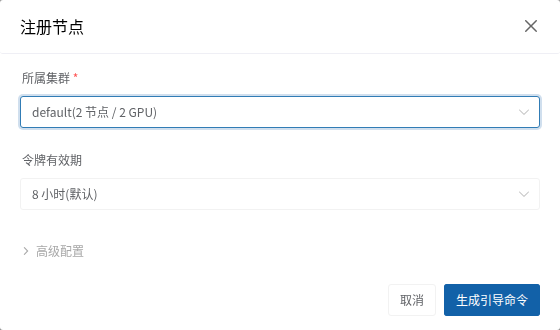
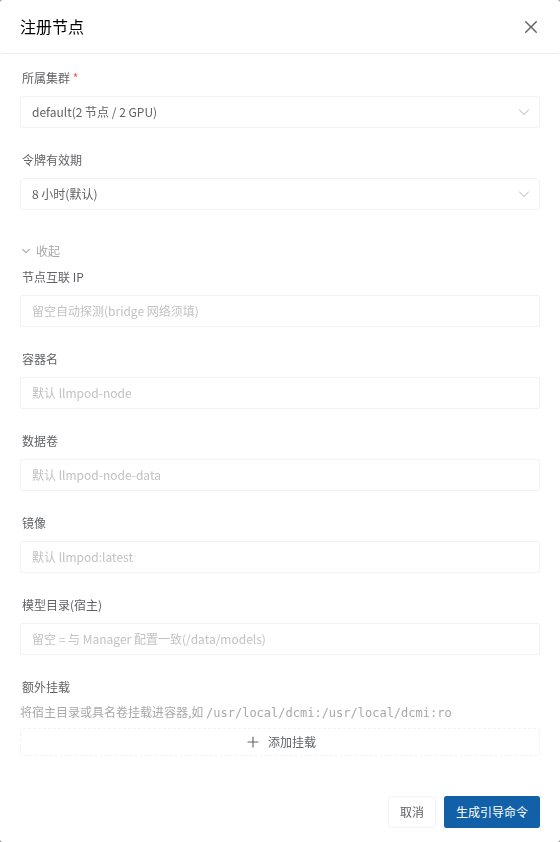
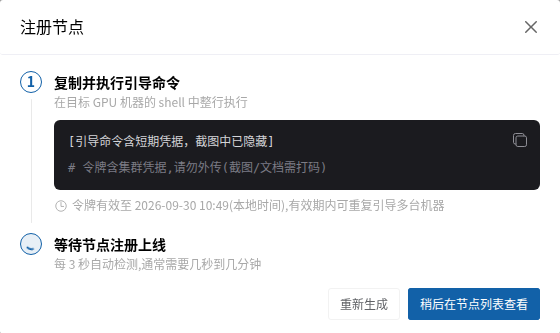
- 在“节点列表”选择注册节点,选择目标集群和引导令牌有效期。按需要填写节点互联 IP、容器名、节点镜像或宿主模型目录等参数。
- 复制控制台返回的完整命令,在目标节点的终端执行。引导命令含短期授权信息,不要把它贴进公开工单或长期脚本。
- 如果没有提前填写互联 IP,脚本会在交互终端要求选择或输入;无人值守执行必须事先提供明确 IP,脚本不会替你猜测。
- 引导脚本检查 Docker、设备和运行环境,然后启动 Node 容器。硬件检查发现缺件时,会明确提示并按执行方式要求处理,不会把 GPU 节点悄悄当作正常 GPU 节点接入。
- 回到“节点列表”,等待节点上线。打开节点详情,核对状态、主机地址、GPU 与 CPU/内存信息;再开始添加模型和创建部署。
控制台支持按集群签发引导命令。不要自己拼接 URL 或写死集群 ID;数据库重建后原 ID 可能不再对应同一个集群。
上线后验证
在目标机查看节点容器状态和日志;默认容器名通常是 llmpod-node,如果注册时改过名称,请替换:
docker ps --filter name=llmpod-node
docker logs --tail 100 llmpod-node
控制台节点状态应为在线,GPU 信息应与宿主机硬件一致。节点使用 --network host 运行;多机部署或多卡并行时,错误的互联 IP 可能导致节点看似在线、部署却无法正常通信。
接入失败时
| 表现 | 检查方向 |
|---|---|
| 引导 URL 无法访问 | Manager 对外地址、控制面端口、防火墙或反向代理;从节点机验证访问 |
| 容器启动后节点不上线 | Node 日志、Manager 的 /ws/node 连接、引导令牌及 Manager 地址 |
| 节点在线但 GPU 缺失 | 宿主驱动、NVIDIA Container Toolkit 或 Ascend 设备映射、容器运行时配置 |
| 部署运行中但跨节点通信失败 | 引导时钉定的节点互联 IP、机器之间的网络可达性 |
节点地址和挂载需要调整时,优先从控制台重新生成引导命令并在目标机重跑;节点数据卷会保存身份。