接入已有推理服务
已有可访问的推理服务时,可以从来源端点开始,无需先添加 LLMPod 模型记录或 GPU 节点。入口是管理员控制台 → 基础设施 → 发布中心 → 供应商管理。这个页签当前维护的是端点;一个端点表示一个可连接的上游模型服务。
准备信息
| 字段 | 填写内容 | 示例 |
|---|---|---|
| 协议 | 上游提供的兼容协议 | OpenAI 或 Anthropic |
| 端点名称 | 管理员识别该来源的名称 | 生产环境 Chat 服务 |
| 转发基址 | 推理网关能够访问的上游基址 | https://api.example.com/v1 |
| 上游模型名 | 上游服务实际接受的 model 值 | example-chat |
| 外部 API Key | 上游要求的凭据;不需要鉴权的本地端点可留空 | 从安全存储取得 |
转发基址 是上游地址,不是 LLMPod 给应用使用的 API 地址。请从运行推理网关的服务器或容器确认它能够连接上游;浏览器能打开该地址并不能证明网关可达。
创建时 Manager 控制面也要访问该地址进行探测,实际调用时推理网关也要访问它。127.0.0.1 在两个服务中分别指向各自的运行环境;只有上游同时能被 Manager 和推理网关通过该地址访问时才能这样填写。跨机器或容器部署应使用两者都可达的地址。
添加端点
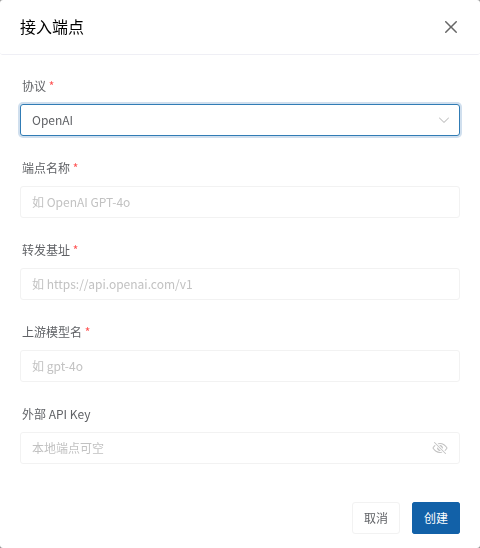
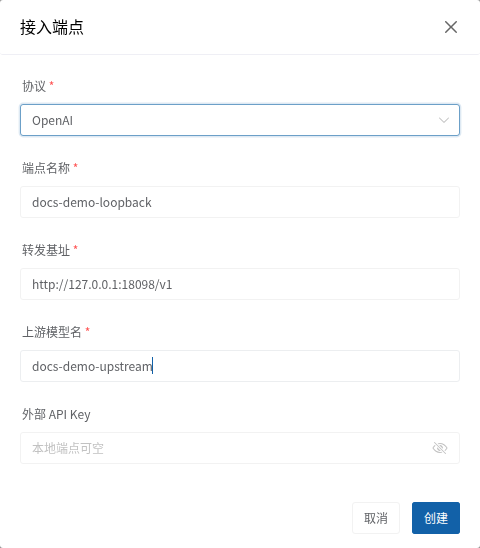
- 在“供应商管理”页签选择接入端点,填写以上字段并保存。提交时控制面会向上游发送一次最小对话请求;上游未返回 2xx JSON 时会拒绝登记,并给出探测错误。
- 返回端点列表,核对名称、协议、地址与启用状态。列表可编辑、停用或删除端点;当前界面没有独立的“探测”按钮。
- 前往发布模型,创建对外模型名并将端点绑定到发布路由。

两种模型名
上游模型名发给实际推理服务;对外模型名由 LLMPod 发布,供租户和应用在请求中使用。两个名称可以不同。
添加端点本身不会使它出现在租户模型市场,也不会让 API Key 自动获得访问权。完成发布后,再使用推理 API做端到端验证。
仅支持 Embeddings 或 Rerank 的上游
当前控制台的接入探测固定发送对话请求,只提供 Embeddings 或 Rerank 的端点可能因此被误判为不可接入。管理 API 支持逐条设置 skip_probe=true 登记这类端点,并可传入其支持操作;跳过探测后必须自行验证对应推理接口。控制台目前未开放这两个字段的编辑。